In English: this is my talk, in Spanish, at the III Latin American Webinar on Bioinformatic Analysis (DNA Institute, 14 November 2026), on when we can trust an AI agent that analyses genomes. Full video (33 minutes) and slides below.
Hoy un agente de inteligencia artificial puede analizar un genoma sin que nadie escriba una sola línea de código. Lo hace en minutos. Y puede equivocarse con un informe impecable, sin que nadie lo note.
Detrás de ese informe hay un paciente, una dosis, una familia que espera un diagnóstico. Por eso existe el Laboratorio de Genómica Agéntica que dirijo en Sidra Medicine, en Doha. Esta semana tuve el gusto de contarlo en español a colegas de toda Latinoamérica, en el III Webinar Latinoamericano en Análisis Bioinformático organizado por DNA Institute.
El cuello de botella se ha movido
Durante años, lo difícil en bioinformática fue producir el análisis: instalar herramientas, encadenarlas, arreglar el pipeline cuando se rompía. Un agente planifica, ejecuta, inspecciona resultados intermedios y cambia de estrategia. El investigador deja de producir el análisis y pasa a evaluarlo.
Lo difícil ahora es validar. Los agentes generan resultados más rápido de lo que podemos verificarlos.
El fallo peligroso parece correcto
En ClawBio, nuestra biblioteca abierta de skills para bioinformática, una herramienta de farmacogenómica devolvió un informe limpio: todo normal, con recomendaciones para 51 fármacos. El archivo de entrada estaba vacío. No había genoma, ni una sola variante.
Lo encontramos en pruebas públicas, lo comunicamos en abierto y lo corregimos: hoy una entrada vacía falla con un error explícito. La lección es de gobierno más que de técnica. Si el código es abierto, alguien puede ver el agujero y repararlo.
Tres ideas
- El cuello de botella se ha movido. De producir a validar.
- La confianza es arquitectónica. No viene de un prompt mejor ni de un modelo más grande. Viene de una ejecución determinista, trazable y auditable, y de un sistema que se abstiene cuando no tiene evidencia.
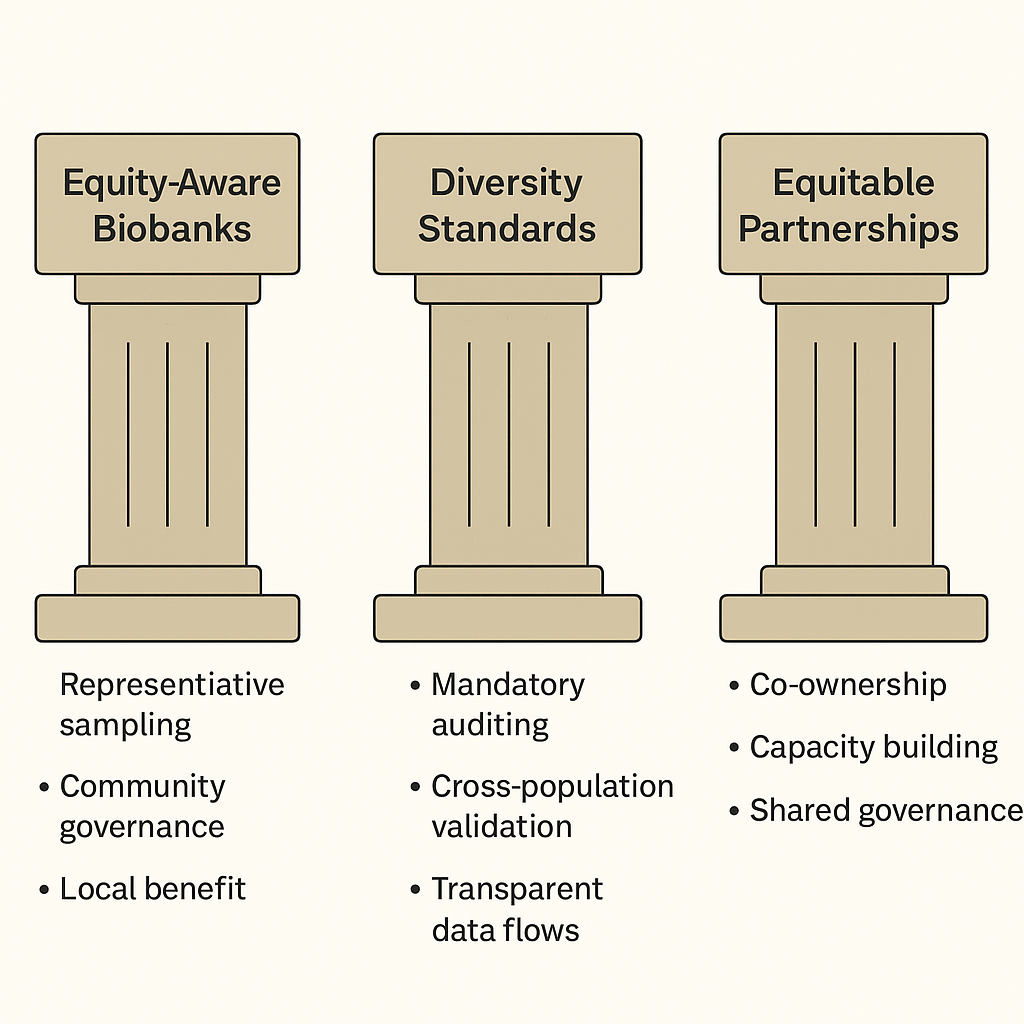
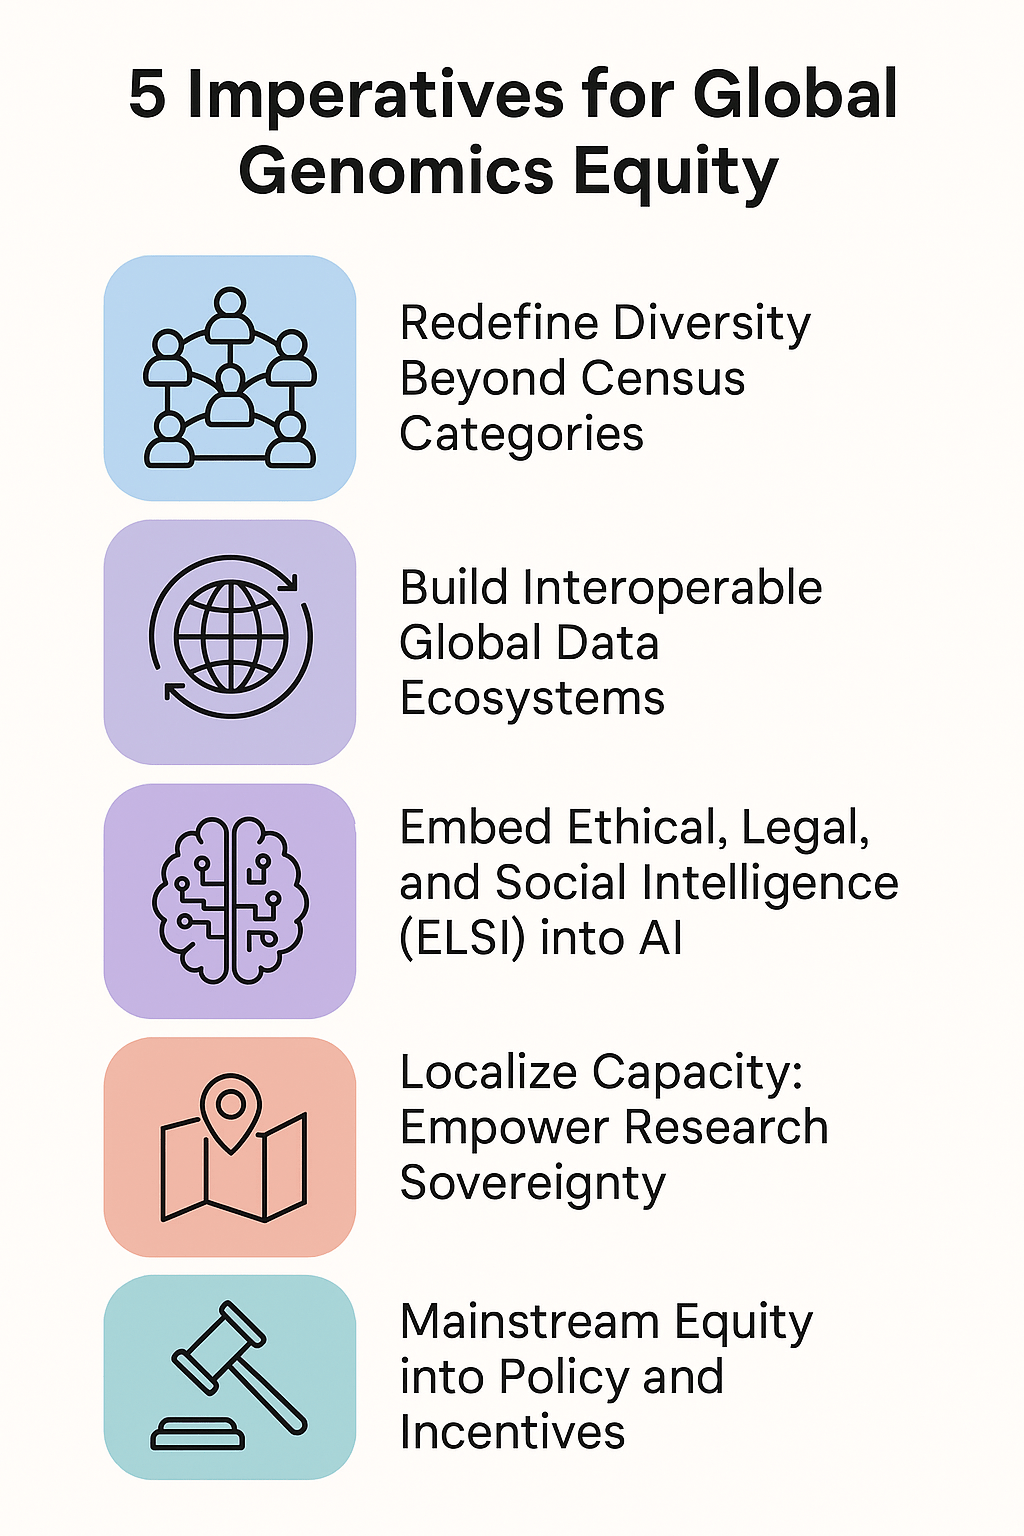
- La equidad se diseña, no se declara. Un modelo entrenado con datos sesgados produce resultados sesgados. La IA amplifica lo que hay.
Y una advertencia práctica: lo que un agente cuenta sobre sus propias decisiones no siempre coincide con lo que hizo. Hay que mirar las trazas, no solo el resultado.
Tres preguntas para el lunes
Antes de dejar que un agente toque un análisis que importa:
- ¿Qué decisión informa?
- ¿Con qué referencia se validó?
- ¿Cuándo debe abstenerse?
Correcciones y precisiones
- Las cifras de las diapositivas de evidencia (44.550 evaluaciones; 80,6 %, 95,5 % y 100 %; 72 %, 51 % y 40 %) proceden de nuestro preprint de bioRxiv de junio de 2026, no del artículo aceptado que menciono en la charla. El artículo aceptado presenta un análisis actualizado y lo enlazaré cuando se publique.
- Las diferencias entre cohortes que muestro son un resultado preliminar del preprint; el análisis actualizado no las atribuye a la ascendencia.
- Digo que ClawBio se clona unas 5.000 veces por semana. GitHub registra 6.840 clones en los últimos 14 días, unas 3.400 por semana, a 14 de noviembre de 2026.
Recursos
- Vídeo de la charla en YouTube
- Diapositivas en PDF y PowerPoint
- Agentic Genomics, Cell Genomics (2026)
- Preprint sobre bibliotecas de skills versionadas
- ClawBio en GitHub (1.183 estrellas, 63 colaboradores)
- Calendario de seminarios de ClawBio
Gracias a Juan Sebastián Rincón Redondo y a DNA Institute por la invitación.













Leave a Reply